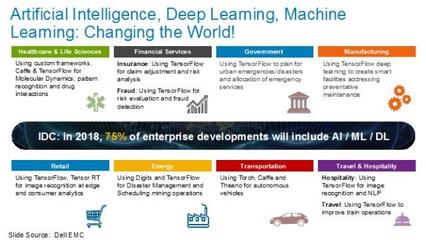
在人工智能技術迅猛發(fā)展的今天,人工智能應用軟件已成為推動產(chǎn)業(yè)升級和社會變革的重要力量。從智能語音助手到自動駕駛系統(tǒng),從醫(yī)療影像分析到金融風控模型,人工智能應用軟件正滲透到各個領域,展現(xiàn)出巨大的潛力和價值。開發(fā)一款成功的人工智能應用軟件并非易事,它涉及多學科知識的融合、復雜的技術棧以及嚴謹?shù)墓こ虒嵺`。本文將淺談人工智能應用軟件開發(fā)的核心概念、關鍵步驟與挑戰(zhàn),為初學者和從業(yè)者提供一份基礎指南。
一、人工智能應用軟件的核心構(gòu)成
人工智能應用軟件通常由數(shù)據(jù)層、算法層、應用層三大部分構(gòu)成。數(shù)據(jù)層負責數(shù)據(jù)的采集、清洗、標注與管理,是人工智能的“燃料”;算法層包括機器學習、深度學習等模型的設計、訓練與優(yōu)化,是軟件的“大腦”;應用層則將算法能力封裝成具體的功能或服務,如圖像識別接口、推薦引擎等,面向最終用戶或系統(tǒng)。這三層相互依賴,缺一不可。例如,一款智能客服軟件需要依賴高質(zhì)量的對話數(shù)據(jù)(數(shù)據(jù)層),結(jié)合自然語言處理算法(算法層),最終實現(xiàn)自動問答或情感分析功能(應用層)。
二、開發(fā)流程:從需求到部署
人工智能應用軟件的開發(fā)遵循迭代式的流程,主要包括以下階段:
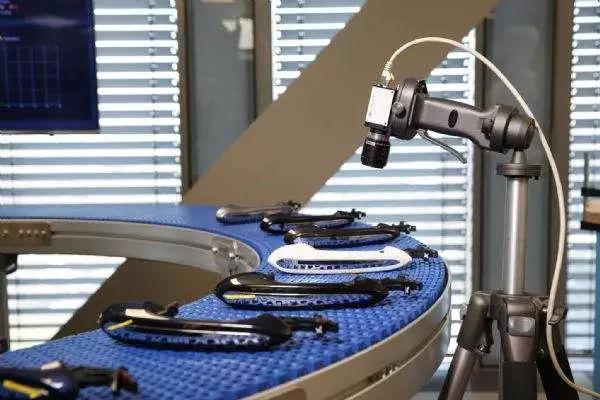
- 需求分析與問題定義:明確軟件要解決的具體問題,如“通過圖像識別檢測工業(yè)零件缺陷”。這一步需結(jié)合業(yè)務場景,確定可行性及評估指標(如準確率、響應速度)。
- 數(shù)據(jù)準備與處理:收集相關數(shù)據(jù),并進行清洗、標注和增強。數(shù)據(jù)質(zhì)量直接決定模型性能,通常占用開發(fā)時間的70%以上。
- 模型選擇與訓練:根據(jù)問題類型(如分類、回歸)選擇合適的算法(如卷積神經(jīng)網(wǎng)絡、決策樹),使用訓練數(shù)據(jù)優(yōu)化模型參數(shù)。過程中需不斷調(diào)參和驗證,避免過擬合或欠擬合。
- 集成與測試:將訓練好的模型嵌入軟件框架,進行功能測試、性能測試和用戶驗收測試。重點驗證軟件在真實環(huán)境中的穩(wěn)定性和準確性。
- 部署與維護:將軟件部署到服務器、邊緣設備或云平臺,并持續(xù)監(jiān)控其運行狀態(tài),根據(jù)反饋數(shù)據(jù)迭代更新模型。
三、關鍵技術與工具
現(xiàn)代人工智能應用軟件開發(fā)依賴于豐富的工具生態(tài):
- 編程語言與框架:Python是主流語言,配合TensorFlow、PyTorch等深度學習框架,可高效實現(xiàn)算法;對于高性能需求,C++或Java常用于應用層開發(fā)。
- 數(shù)據(jù)處理工具:Pandas、NumPy用于數(shù)據(jù)操作,LabelImg等工具輔助標注。
- 部署平臺:Docker容器化技術簡化部署,Kubernetes支持大規(guī)模集群管理;云服務(如AWS SageMaker、Google AI Platform)提供一站式開發(fā)環(huán)境。
- 倫理與安全考量:開發(fā)中需關注數(shù)據(jù)隱私(如GDPR合規(guī))、算法公平性(避免偏見)和系統(tǒng)安全性(防御對抗攻擊)。
四、挑戰(zhàn)與未來趨勢
人工智能應用軟件開發(fā)仍面臨諸多挑戰(zhàn):數(shù)據(jù)稀缺或質(zhì)量低下可能導致模型失效;算法“黑箱”特性使得決策過程難以解釋;高計算資源需求增加成本。隨著自動化機器學習(AutoML)的普及,開發(fā)門檻將逐步降低;邊緣AI推動軟件在物聯(lián)網(wǎng)設備中的部署;可解釋AI(XAI)技術有望增強透明度和信任度。開發(fā)者需保持學習,緊跟技術演進。
人工智能應用軟件開發(fā)是一個跨學科的實踐過程,融合了計算機科學、數(shù)學和領域知識。只有深入理解基礎概念,掌握核心工具,并在實踐中不斷優(yōu)化,才能創(chuàng)造出真正賦能社會的智能軟件。對于初學者而言,從一個小型項目入手(如基于公開數(shù)據(jù)集的手寫數(shù)字識別),逐步積累經(jīng)驗,是踏入這一領域的有效途徑。